Generative Adversarial Networks solve a problem that has no clean supervised learning solution: synthesizing new examples of a category when you do not have enough real examples to train on. In marine computer vision, that problem is a constant. Many species of interest are rarely encountered, difficult to photograph, or found at depths that require expensive equipment. The result is that even well-curated datasets tend to be small and imbalanced. A detector trained on 200 images of one species and 2000 of another will systematically underperform on the minority class, regardless of how sophisticated the architecture is.
GANs address this directly by learning the image distribution from the available examples and then sampling new images from that distribution. If the generator learns the distribution well, the synthetic images it produces are statistically consistent with the real ones and can be used to pad the training set for the minority class.
This notebook trains a Deep Convolutional GAN (DCGAN) on a dataset of sea star images. The architecture follows the original DCGAN paper: the generator uses transposed convolutions to upsample a 100-dimensional noise vector into a 64x64 RGB image, and the discriminator uses strided convolutions to classify images as real or fake. Training alternates between updating the discriminator and updating the generator, with each network receiving gradients calculated from the binary cross-entropy loss on its respective objective.
The training run is divided into four 200-epoch blocks so you can evaluate output quality at each stage. By comparing the generated grids across rounds, you will observe the full arc of GAN training from structured noise to recognizable synthetic organisms.
Prerequisites: Lessons 3.1 through 3.16. Familiarity with convolutional neural networks, binary cross-entropy loss, and backpropagation.
Expected runtime: Approximately 30 to 45 minutes on a Colab T4 GPU across all four training blocks.
import os
import urllib.request
import zipfile

dataset_url = "https://storage.googleapis.com/public-datasets-lila/sea-star-re-id/sea-star-re-id.zip"
zip_path = "sea-star-re-id.zip"
extract_dir = "seastar_data"

if not os.path.exists(zip_path):
    print("Downloading dataset...")
    urllib.request.urlretrieve(dataset_url, zip_path)
    print("Download complete.")

if not os.path.exists(extract_dir):
    print("Extracting dataset...")
    with zipfile.ZipFile(zip_path, 'r') as zip_ref:
        zip_ref.extractall(extract_dir)
    print("Extraction complete.")
Downloading dataset...
Download complete.
Extracting dataset...
Extraction complete.
import torch
from torch.utils.data import Dataset, DataLoader
from torchvision import transforms
from PIL import Image
import glob
import matplotlib.pyplot as plt
import numpy as np
import os

# Find all ASRU images
asru_images = glob.glob(os.path.join(extract_dir, 'sea-star-re-id', 'Anau*', '*.jpg'))
print(f"Found {len(asru_images)} Anthenea australiae images.")

class SeaStarDataset(Dataset):
    def __init__(self, image_paths, transform=None):
        self.image_paths = image_paths
        self.transform = transform

    def __len__(self):
        return len(self.image_paths)

    def __getitem__(self, idx):
        img = Image.open(self.image_paths[idx]).convert('RGB')
        if self.transform:
            img = self.transform(img)
        return img

# Transform for DCGAN
image_size = 64
batch_size = 256

transform = transforms.Compose([
    transforms.Resize((image_size, image_size)),
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])

dataset = SeaStarDataset(asru_images, transform=transform)
dataloader = DataLoader(dataset, batch_size=batch_size, shuffle=True, num_workers=12, pin_memory=True)
Found 983 Anthenea australiae images.
import torch.nn as nn

nz = 100 # Size of latent vector (generator input)

class Generator(nn.Module):
    def __init__(self):
        super(Generator, self).__init__()
        self.main = nn.Sequential(
            nn.ConvTranspose2d(nz, 512, 4, 1, 0, bias=False),
            nn.BatchNorm2d(512),
            nn.ReLU(True),
            nn.ConvTranspose2d(512, 256, 4, 2, 1, bias=False),
            nn.BatchNorm2d(256),
            nn.ReLU(True),
            nn.ConvTranspose2d(256, 128, 4, 2, 1, bias=False),
            nn.BatchNorm2d(128),
            nn.ReLU(True),
            nn.ConvTranspose2d(128, 64, 4, 2, 1, bias=False),
            nn.BatchNorm2d(64),
            nn.ReLU(True),
            nn.ConvTranspose2d(64, 3, 4, 2, 1, bias=False),
            nn.Tanh()
        )

    def forward(self, input):
        return self.main(input)

class Discriminator(nn.Module):
    def __init__(self):
        super(Discriminator, self).__init__()
        self.main = nn.Sequential(
            nn.Conv2d(3, 64, 4, 2, 1, bias=False),
            nn.LeakyReLU(0.2, inplace=True),
            nn.Conv2d(64, 128, 4, 2, 1, bias=False),
            nn.BatchNorm2d(128),
            nn.LeakyReLU(0.2, inplace=True),
            nn.Conv2d(128, 256, 4, 2, 1, bias=False),
            nn.BatchNorm2d(256),
            nn.LeakyReLU(0.2, inplace=True),
            nn.Conv2d(256, 512, 4, 2, 1, bias=False),
            nn.BatchNorm2d(512),
            nn.LeakyReLU(0.2, inplace=True),
            nn.Conv2d(512, 1, 4, 1, 0, bias=False),
            nn.Sigmoid()
        )

    def forward(self, input):
        return self.main(input)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
netG = Generator().to(device)
netD = Discriminator().to(device)
print(f"Currently using device: {device}")
if device.type == 'cuda':
    print(f"GPU Model: {torch.cuda.get_device_name(0)}")
Currently using device: cuda
GPU Model: NVIDIA A100-SXM4-40GB
import torch.optim as optim
import torch.backends.cudnn as cudnn

# Enable cudnn benchmark for faster convolutions on fixed-size inputs
cudnn.benchmark = True

criterion = nn.BCELoss()
optimizerD = optim.Adam(netD.parameters(), lr=0.0001, betas=(0.5, 0.999))
optimizerG = optim.Adam(netG.parameters(), lr=0.0002, betas=(0.5, 0.999))

epochs = 100

print("Starting Training Loop with CPU or GPU...")
for epoch in range(epochs):
    for i, data in enumerate(dataloader, 0):
        # 1. Update Discriminator
        netD.zero_grad()
        real_cpu = data.to(device)
        b_size = real_cpu.size(0)
        label = torch.full((b_size,), 0.9, dtype=torch.float, device=device)
        output = netD(real_cpu).view(-1)
        errD_real = criterion(output, label)
        errD_real.backward()

        noise = torch.randn(b_size, nz, 1, 1, device=device)
        fake = netG(noise)
        label.fill_(0.)
        output = netD(fake.detach()).view(-1)
        errD_fake = criterion(output, label)
        errD_fake.backward()
        optimizerD.step()

        # 2. Update Generator
        netG.zero_grad()
        label.fill_(1.)  # fake labels are real for generat r cost
        output = netD(fake).view(-1)
        errG = criterion(output, label)
        errG.backward()
        optimizerG.step()

    print(f'[{epoch+1}/{epochs}] Loss_D: {errD_real.item() + errD_fake.item():.4f} Loss_G: {errG.item():.4f}')
Starting Training Loop with CPU or GPU...
[1/100] Loss_D: 1.1177 Loss_G: 4.2531
[2/100] Loss_D: 1.1838 Loss_G: 2.9743
[3/100] Loss_D: 0.9467 Loss_G: 3.3412
[4/100] Loss_D: 0.9256 Loss_G: 3.0027
[5/100] Loss_D: 0.8672 Loss_G: 3.8548
[6/100] Loss_D: 0.7440 Loss_G: 4.0515
[7/100] Loss_D: 1.1023 Loss_G: 4.7933
[8/100] Loss_D: 0.8798 Loss_G: 4.8080
[9/100] Loss_D: 0.8376 Loss_G: 3.7502
[10/100] Loss_D: 1.2272 Loss_G: 3.5025
[11/100] Loss_D: 0.9334 Loss_G: 2.0551
[12/100] Loss_D: 0.9727 Loss_G: 3.0524
[13/100] Loss_D: 0.7586 Loss_G: 3.3222
[14/100] Loss_D: 0.9670 Loss_G: 2.9214
[15/100] Loss_D: 0.9180 Loss_G: 3.1201
[16/100] Loss_D: 0.9176 Loss_G: 3.2538
[17/100] Loss_D: 0.8420 Loss_G: 2.6973
[18/100] Loss_D: 0.8553 Loss_G: 2.7976
[19/100] Loss_D: 0.8913 Loss_G: 2.9173
[20/100] Loss_D: 0.9632 Loss_G: 3.6935
[21/100] Loss_D: 0.6893 Loss_G: 3.4118
[22/100] Loss_D: 0.8196 Loss_G: 2.7601
[23/100] Loss_D: 0.9063 Loss_G: 3.5906
[24/100] Loss_D: 0.8778 Loss_G: 3.4762
[25/100] Loss_D: 1.0989 Loss_G: 2.9723
[26/100] Loss_D: 0.8211 Loss_G: 3.7521
[27/100] Loss_D: 0.8230 Loss_G: 2.6652
[28/100] Loss_D: 0.8445 Loss_G: 3.2301
[29/100] Loss_D: 0.7426 Loss_G: 3.6415
[30/100] Loss_D: 0.6407 Loss_G: 3.8309
[31/100] Loss_D: 0.9310 Loss_G: 3.7993
[32/100] Loss_D: 0.7179 Loss_G: 3.3470
[33/100] Loss_D: 0.8246 Loss_G: 3.4518
[34/100] Loss_D: 0.9816 Loss_G: 5.7093
[35/100] Loss_D: 0.9453 Loss_G: 2.5683
[36/100] Loss_D: 0.8351 Loss_G: 3.0169
[37/100] Loss_D: 0.7524 Loss_G: 3.0171
[38/100] Loss_D: 0.9141 Loss_G: 3.2237
[39/100] Loss_D: 0.8146 Loss_G: 2.9422
[40/100] Loss_D: 0.7114 Loss_G: 3.3112
[41/100] Loss_D: 0.8335 Loss_G: 3.9253
[42/100] Loss_D: 0.7303 Loss_G: 2.8289
[43/100] Loss_D: 0.9585 Loss_G: 3.9998
[44/100] Loss_D: 0.7858 Loss_G: 3.1429
[45/100] Loss_D: 0.8013 Loss_G: 2.6354
[46/100] Loss_D: 0.7795 Loss_G: 2.7541
[47/100] Loss_D: 0.7934 Loss_G: 3.2312
[48/100] Loss_D: 0.7563 Loss_G: 2.8906
[49/100] Loss_D: 0.7438 Loss_G: 3.0595
[50/100] Loss_D: 0.7584 Loss_G: 4.0264
[51/100] Loss_D: 0.6466 Loss_G: 4.4471
[52/100] Loss_D: 0.7209 Loss_G: 4.9379
[53/100] Loss_D: 0.9258 Loss_G: 2.5087
[54/100] Loss_D: 0.8145 Loss_G: 3.6939
[55/100] Loss_D: 0.9207 Loss_G: 2.5757
[56/100] Loss_D: 0.7660 Loss_G: 3.2798
[57/100] Loss_D: 1.0930 Loss_G: 4.7763
[58/100] Loss_D: 0.7968 Loss_G: 2.5676
[59/100] Loss_D: 0.9715 Loss_G: 3.3634
[60/100] Loss_D: 0.6503 Loss_G: 2.7063
[61/100] Loss_D: 0.6781 Loss_G: 2.4754
[62/100] Loss_D: 0.7245 Loss_G: 2.5282
[63/100] Loss_D: 0.6840 Loss_G: 2.8739
[64/100] Loss_D: 0.7566 Loss_G: 2.5475
[65/100] Loss_D: 0.7280 Loss_G: 2.9444
[66/100] Loss_D: 0.7745 Loss_G: 3.3941
[67/100] Loss_D: 0.7199 Loss_G: 3.4119
[68/100] Loss_D: 0.7331 Loss_G: 4.0031
[69/100] Loss_D: 0.8180 Loss_G: 4.3700
[70/100] Loss_D: 0.9156 Loss_G: 3.7697
[71/100] Loss_D: 0.7892 Loss_G: 2.9598
[72/100] Loss_D: 0.8525 Loss_G: 2.2668
[73/100] Loss_D: 0.7720 Loss_G: 3.5258
[74/100] Loss_D: 0.7814 Loss_G: 3.7094
[75/100] Loss_D: 1.0106 Loss_G: 4.8127
[76/100] Loss_D: 0.7317 Loss_G: 3.1045
[77/100] Loss_D: 0.7507 Loss_G: 2.3518
[78/100] Loss_D: 0.7008 Loss_G: 3.1506
[79/100] Loss_D: 0.9102 Loss_G: 4.5895
[80/100] Loss_D: 0.6628 Loss_G: 3.0384
[81/100] Loss_D: 0.6740 Loss_G: 3.4441
[82/100] Loss_D: 0.9687 Loss_G: 3.5323
[83/100] Loss_D: 0.8556 Loss_G: 2.3020
[84/100] Loss_D: 0.7515 Loss_G: 2.3755
[85/100] Loss_D: 1.3132 Loss_G: 2.6658
[86/100] Loss_D: 0.7626 Loss_G: 2.5958
[87/100] Loss_D: 0.6815 Loss_G: 3.5290
[88/100] Loss_D: 0.7427 Loss_G: 3.8618
[89/100] Loss_D: 0.7540 Loss_G: 3.9546
[90/100] Loss_D: 0.7484 Loss_G: 3.1523
[91/100] Loss_D: 0.8070 Loss_G: 4.1278
[92/100] Loss_D: 0.6408 Loss_G: 2.6871
[93/100] Loss_D: 0.6937 Loss_G: 3.3014
[94/100] Loss_D: 0.8802 Loss_G: 3.9789
[95/100] Loss_D: 0.7080 Loss_G: 3.2677
[96/100] Loss_D: 0.7980 Loss_G: 2.8199
[97/100] Loss_D: 0.7086 Loss_G: 3.9863
[98/100] Loss_D: 0.6972 Loss_G: 3.2849
[99/100] Loss_D: 0.6424 Loss_G: 3.1091
[100/100] Loss_D: 0.8021 Loss_G: 4.2319
Evaluating Generator Output (Round 1)
After 100 initial training epochs, the generator has had enough iterations to develop rough structural responses to the input noise, but not enough to produce fine texture or sharp edges. The output grid at this stage typically shows blurry, low-frequency blobs that gesture toward sea star shapes without committing to them. That is normal and expected.
The reason the early outputs are soft rather than incoherent noise comes down to label smoothing. Instead of training the discriminator to classify real images with a target label of 1.0, the code uses 0.9. This small adjustment prevents the discriminator from becoming overconfident during the first few hundred batches. An overconfident discriminator produces gradients that are nearly zero at its output, which propagates almost no learning signal back through the generator. Label smoothing keeps the discriminator’s confidence slightly uncertain, preserving a usable gradient for the generator to learn from.
Look at the 16-image grid and ask: do you see any shapes that are consistent across multiple samples? Consistent shape emergence, even without detail, is the sign that training is proceeding normally. Uniform gray or pure noise at this stage would indicate a problem with the generator architecture or the learning rate balance between the two networks.
import torchvision.utils as vutils

# Generate a batch of fake images
noise = torch.randn(16, nz, 1, 1, device=device)
with torch.no_grad():
    fake_images = netG(noise).detach().cpu()

# Plot the fake images
plt.figure(figsize=(8,8))
plt.axis("off")
plt.title("Synthetic Sea Stars")
plt.imshow(np.transpose(vutils.make_grid(fake_images, padding=2, normalize=True), (1, 2, 0)))
plt.show()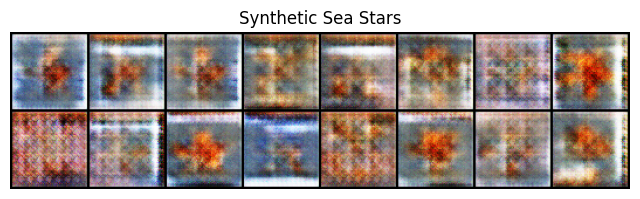
Continuing Adversarial Training
GAN training is a two-player minimax game. The generator attempts to minimize its loss (fool the discriminator), while the discriminator attempts to maximize its accuracy (correctly classify real versus fake). In theory these objectives push toward a Nash equilibrium where the generator produces images indistinguishable from real ones and the discriminator is no better than a coin flip. In practice, that equilibrium is rarely reached cleanly, and the dynamics of getting there require careful monitoring.
Watch the loss trends across these additional 200-epoch blocks. Neither network should consistently dominate:
If the discriminator loss collapses to near zero, the discriminator has learned to identify fakes trivially. The generator is receiving a near-zero gradient and is no longer improving. This is called discriminator dominance.
If the generator loss climbs steadily, the discriminator is too powerful relative to the generator’s current capacity. The adversarial signal is present but too harsh for productive learning.
A healthy training run shows both losses fluctuating within a moderate range, with neither trending monotonically toward zero or infinity. Some oscillation is normal and expected.
Each 200-epoch block in this notebook is deliberately short so you can observe the loss trajectory and generated image quality at multiple checkpoints rather than waiting for a single long run to complete.
additional_epochs = 200

print(f"Resuming Training Loop for {additional_epochs} more epochs...")
for epoch in range(additional_epochs):
    for i, data in enumerate(dataloader, 0):
        # 1. Update Discriminator
        netD.zero_grad()
        real_cpu = data.to(device)
        b_size = real_cpu.size(0)

        # Real labels are smoothed to 0.9
        label = torch.full((b_size,), 0.9, dtype=torch.float, device=device)
        output = netD(real_cpu).view(-1)
        errD_real = criterion(output, label)
        errD_real.backward()

        noise = torch.randn(b_size, nz, 1, 1, device=device)
        fake = netG(noise)
        label.fill_(0.)
        output = netD(fake.detach()).view(-1)
        errD_fake = criterion(output, label)
        errD_fake.backward()
        optimizerD.step()

        # 2. Update Generator
        netG.zero_grad()
        label.fill_(1.)  # fake labels are real for generator cost
        output = netD(fake).view(-1)
        errG = criterion(output, label)
        errG.backward()
        optimizerG.step()

    print(f'[Continued {epoch+1}/{additional_epochs}] Loss_D: {errD_real.item() + errD_fake.item():.4f} Loss_G: {errG.item():.4f}')
Resuming Training Loop for 200 more epochs...
[Continued 1/200] Loss_D: 0.6997 Loss_G: 2.8628
[Continued 2/200] Loss_D: 1.3260 Loss_G: 3.3962
[Continued 3/200] Loss_D: 0.7051 Loss_G: 2.2087
[Continued 4/200] Loss_D: 0.8782 Loss_G: 3.6395
[Continued 5/200] Loss_D: 0.7103 Loss_G: 2.9983
[Continued 6/200] Loss_D: 0.7363 Loss_G: 3.8512
[Continued 7/200] Loss_D: 0.6538 Loss_G: 2.7795
[Continued 8/200] Loss_D: 0.6657 Loss_G: 3.1862
[Continued 9/200] Loss_D: 0.6857 Loss_G: 2.2930
[Continued 10/200] Loss_D: 0.6840 Loss_G: 2.7473
[Continued 11/200] Loss_D: 0.8860 Loss_G: 4.3787
[Continued 12/200] Loss_D: 0.6071 Loss_G: 2.4680
[Continued 13/200] Loss_D: 0.6982 Loss_G: 2.7549
[Continued 14/200] Loss_D: 0.8147 Loss_G: 3.5478
[Continued 15/200] Loss_D: 0.8307 Loss_G: 5.0624
[Continued 16/200] Loss_D: 0.8088 Loss_G: 2.2432
[Continued 17/200] Loss_D: 0.6555 Loss_G: 3.7278
[Continued 18/200] Loss_D: 0.8412 Loss_G: 2.8611
[Continued 19/200] Loss_D: 0.6813 Loss_G: 3.1221
[Continued 20/200] Loss_D: 0.6907 Loss_G: 3.9870
[Continued 21/200] Loss_D: 0.7061 Loss_G: 2.4068
[Continued 22/200] Loss_D: 1.2231 Loss_G: 3.3424
[Continued 23/200] Loss_D: 0.6140 Loss_G: 2.6409
[Continued 24/200] Loss_D: 0.7919 Loss_G: 2.6017
[Continued 25/200] Loss_D: 0.6091 Loss_G: 3.6763
[Continued 26/200] Loss_D: 0.5970 Loss_G: 3.0724
[Continued 27/200] Loss_D: 0.7801 Loss_G: 4.6128
[Continued 28/200] Loss_D: 0.5329 Loss_G: 3.1291
[Continued 29/200] Loss_D: 0.5990 Loss_G: 3.4923
[Continued 30/200] Loss_D: 0.6036 Loss_G: 3.2754
[Continued 31/200] Loss_D: 0.6734 Loss_G: 3.2650
[Continued 32/200] Loss_D: 0.7064 Loss_G: 3.3443
[Continued 33/200] Loss_D: 0.6977 Loss_G: 4.0185
[Continued 34/200] Loss_D: 0.8679 Loss_G: 4.4012
[Continued 35/200] Loss_D: 0.6331 Loss_G: 3.4046
[Continued 36/200] Loss_D: 0.5944 Loss_G: 3.9466
[Continued 37/200] Loss_D: 0.6596 Loss_G: 4.3901
[Continued 38/200] Loss_D: 0.8526 Loss_G: 5.3593
[Continued 39/200] Loss_D: 0.6539 Loss_G: 2.8227
[Continued 40/200] Loss_D: 0.6908 Loss_G: 3.7078
[Continued 41/200] Loss_D: 0.7513 Loss_G: 2.8110
[Continued 42/200] Loss_D: 0.6290 Loss_G: 3.6512
[Continued 43/200] Loss_D: 0.7651 Loss_G: 2.7590
[Continued 44/200] Loss_D: 0.8015 Loss_G: 2.1482
[Continued 45/200] Loss_D: 0.5622 Loss_G: 3.9812
[Continued 46/200] Loss_D: 0.6409 Loss_G: 2.6062
[Continued 47/200] Loss_D: 0.5730 Loss_G: 3.1427
[Continued 48/200] Loss_D: 0.6428 Loss_G: 4.3238
[Continued 49/200] Loss_D: 0.5566 Loss_G: 2.9497
[Continued 50/200] Loss_D: 0.8676 Loss_G: 1.7176
[Continued 51/200] Loss_D: 0.5703 Loss_G: 3.9733
[Continued 52/200] Loss_D: 0.7191 Loss_G: 3.5360
[Continued 53/200] Loss_D: 0.6721 Loss_G: 2.9488
[Continued 54/200] Loss_D: 0.6425 Loss_G: 2.9124
[Continued 55/200] Loss_D: 0.6989 Loss_G: 3.0110
[Continued 56/200] Loss_D: 0.6761 Loss_G: 2.8384
[Continued 57/200] Loss_D: 0.6695 Loss_G: 2.9919
[Continued 58/200] Loss_D: 0.6307 Loss_G: 3.2675
[Continued 59/200] Loss_D: 0.6397 Loss_G: 2.7561
[Continued 60/200] Loss_D: 0.6314 Loss_G: 2.8974
[Continued 61/200] Loss_D: 0.5884 Loss_G: 3.1054
[Continued 62/200] Loss_D: 0.5613 Loss_G: 2.7467
[Continued 63/200] Loss_D: 1.5845 Loss_G: 2.1580
[Continued 64/200] Loss_D: 0.6830 Loss_G: 3.1212
[Continued 65/200] Loss_D: 0.7054 Loss_G: 3.4905
[Continued 66/200] Loss_D: 0.6764 Loss_G: 4.2330
[Continued 67/200] Loss_D: 0.9606 Loss_G: 4.7900
[Continued 68/200] Loss_D: 0.7080 Loss_G: 3.1484
[Continued 69/200] Loss_D: 0.6623 Loss_G: 3.0110
[Continued 70/200] Loss_D: 0.6396 Loss_G: 2.6287
[Continued 71/200] Loss_D: 0.6219 Loss_G: 2.8848
[Continued 72/200] Loss_D: 0.5730 Loss_G: 2.8163
[Continued 73/200] Loss_D: 0.6535 Loss_G: 2.6627
[Continued 74/200] Loss_D: 0.7461 Loss_G: 2.3752
[Continued 75/200] Loss_D: 0.5846 Loss_G: 3.2165
[Continued 76/200] Loss_D: 0.5693 Loss_G: 2.8579
[Continued 77/200] Loss_D: 0.6435 Loss_G: 3.8754
[Continued 78/200] Loss_D: 0.8696 Loss_G: 4.9143
[Continued 79/200] Loss_D: 0.7123 Loss_G: 2.2595
[Continued 80/200] Loss_D: 0.7653 Loss_G: 2.1914
[Continued 81/200] Loss_D: 0.6054 Loss_G: 3.6031
[Continued 82/200] Loss_D: 0.6040 Loss_G: 3.2975
[Continued 83/200] Loss_D: 0.6365 Loss_G: 3.5243
[Continued 84/200] Loss_D: 1.0279 Loss_G: 6.3518
[Continued 85/200] Loss_D: 0.6144 Loss_G: 3.3186
[Continued 86/200] Loss_D: 0.7687 Loss_G: 3.3665
[Continued 87/200] Loss_D: 0.6388 Loss_G: 2.9352
[Continued 88/200] Loss_D: 0.5318 Loss_G: 3.2366
[Continued 89/200] Loss_D: 0.6602 Loss_G: 2.9082
[Continued 90/200] Loss_D: 0.7939 Loss_G: 1.5127
[Continued 91/200] Loss_D: 0.5397 Loss_G: 4.0563
[Continued 92/200] Loss_D: 0.5988 Loss_G: 3.0075
[Continued 93/200] Loss_D: 0.6470 Loss_G: 3.8626
[Continued 94/200] Loss_D: 1.4065 Loss_G: 6.4804
[Continued 95/200] Loss_D: 0.7905 Loss_G: 3.0922
[Continued 96/200] Loss_D: 0.7096 Loss_G: 2.9429
[Continued 97/200] Loss_D: 0.5004 Loss_G: 3.6220
[Continued 98/200] Loss_D: 0.5760 Loss_G: 3.4849
[Continued 99/200] Loss_D: 0.6656 Loss_G: 3.7244
[Continued 100/200] Loss_D: 0.8854 Loss_G: 4.8349
[Continued 101/200] Loss_D: 0.6978 Loss_G: 3.2879
[Continued 102/200] Loss_D: 0.6408 Loss_G: 3.6348
[Continued 103/200] Loss_D: 0.5407 Loss_G: 3.2606
[Continued 104/200] Loss_D: 0.6117 Loss_G: 3.2880
[Continued 105/200] Loss_D: 0.8495 Loss_G: 4.4989
[Continued 106/200] Loss_D: 0.5414 Loss_G: 3.1163
[Continued 107/200] Loss_D: 0.5204 Loss_G: 2.8622
[Continued 108/200] Loss_D: 0.8612 Loss_G: 4.9416
[Continued 109/200] Loss_D: 0.5362 Loss_G: 2.9250
[Continued 110/200] Loss_D: 0.5944 Loss_G: 2.8950
[Continued 111/200] Loss_D: 0.6347 Loss_G: 2.2179
[Continued 112/200] Loss_D: 1.2804 Loss_G: 2.4215
[Continued 113/200] Loss_D: 0.7439 Loss_G: 3.0743
[Continued 114/200] Loss_D: 0.6712 Loss_G: 2.7130
[Continued 115/200] Loss_D: 0.5442 Loss_G: 2.9817
[Continued 116/200] Loss_D: 0.7183 Loss_G: 2.2475
[Continued 117/200] Loss_D: 0.5225 Loss_G: 3.7379
[Continued 118/200] Loss_D: 0.6817 Loss_G: 1.9341
[Continued 119/200] Loss_D: 0.5915 Loss_G: 3.6213
[Continued 120/200] Loss_D: 0.6145 Loss_G: 2.8879
[Continued 121/200] Loss_D: 1.1175 Loss_G: 1.3192
[Continued 122/200] Loss_D: 0.7533 Loss_G: 3.9552
[Continued 123/200] Loss_D: 0.5992 Loss_G: 2.9507
[Continued 124/200] Loss_D: 0.6787 Loss_G: 2.0375
[Continued 125/200] Loss_D: 0.5612 Loss_G: 3.6205
[Continued 126/200] Loss_D: 0.6463 Loss_G: 2.9720
[Continued 127/200] Loss_D: 0.6088 Loss_G: 2.7514
[Continued 128/200] Loss_D: 0.5653 Loss_G: 4.0568
[Continued 129/200] Loss_D: 0.6291 Loss_G: 3.4947
[Continued 130/200] Loss_D: 0.6066 Loss_G: 4.3084
[Continued 131/200] Loss_D: 0.7127 Loss_G: 4.2685
[Continued 132/200] Loss_D: 0.6171 Loss_G: 3.1204
[Continued 133/200] Loss_D: 1.0510 Loss_G: 2.0526
[Continued 134/200] Loss_D: 0.6021 Loss_G: 2.9066
[Continued 135/200] Loss_D: 0.5404 Loss_G: 3.3421
[Continued 136/200] Loss_D: 0.5304 Loss_G: 3.0055
[Continued 137/200] Loss_D: 0.6132 Loss_G: 2.5933
[Continued 138/200] Loss_D: 0.5109 Loss_G: 2.7448
[Continued 139/200] Loss_D: 0.6889 Loss_G: 2.2148
[Continued 140/200] Loss_D: 0.5400 Loss_G: 3.1305
[Continued 141/200] Loss_D: 0.5172 Loss_G: 2.7941
[Continued 142/200] Loss_D: 0.5724 Loss_G: 2.4389
[Continued 143/200] Loss_D: 0.9934 Loss_G: 1.3586
[Continued 144/200] Loss_D: 0.6044 Loss_G: 3.8096
[Continued 145/200] Loss_D: 0.5910 Loss_G: 2.7155
[Continued 146/200] Loss_D: 0.5473 Loss_G: 2.7531
[Continued 147/200] Loss_D: 0.5775 Loss_G: 3.7340
[Continued 148/200] Loss_D: 0.6158 Loss_G: 4.0017
[Continued 149/200] Loss_D: 0.8678 Loss_G: 5.2143
[Continued 150/200] Loss_D: 0.5803 Loss_G: 2.4857
[Continued 151/200] Loss_D: 0.5840 Loss_G: 3.1144
[Continued 152/200] Loss_D: 0.5205 Loss_G: 3.3286
[Continued 153/200] Loss_D: 0.5655 Loss_G: 2.6875
[Continued 154/200] Loss_D: 0.6540 Loss_G: 2.0553
[Continued 155/200] Loss_D: 0.5151 Loss_G: 3.0610
[Continued 156/200] Loss_D: 0.5301 Loss_G: 3.1584
[Continued 157/200] Loss_D: 0.9166 Loss_G: 5.9870
[Continued 158/200] Loss_D: 0.6946 Loss_G: 1.7202
[Continued 159/200] Loss_D: 0.6642 Loss_G: 3.5908
[Continued 160/200] Loss_D: 0.5833 Loss_G: 3.1179
[Continued 161/200] Loss_D: 0.5348 Loss_G: 2.8567
[Continued 162/200] Loss_D: 0.5373 Loss_G: 3.1285
[Continued 163/200] Loss_D: 0.8453 Loss_G: 5.8920
[Continued 164/200] Loss_D: 0.5394 Loss_G: 2.7057
[Continued 165/200] Loss_D: 0.6065 Loss_G: 2.9837
[Continued 166/200] Loss_D: 0.5545 Loss_G: 3.5555
[Continued 167/200] Loss_D: 0.6858 Loss_G: 4.6567
[Continued 168/200] Loss_D: 0.5976 Loss_G: 2.8306
[Continued 169/200] Loss_D: 0.5547 Loss_G: 3.4996
[Continued 170/200] Loss_D: 0.6353 Loss_G: 2.0764
[Continued 171/200] Loss_D: 0.8099 Loss_G: 3.3296
[Continued 172/200] Loss_D: 0.5839 Loss_G: 2.7396
[Continued 173/200] Loss_D: 0.6390 Loss_G: 4.3970
[Continued 174/200] Loss_D: 0.5639 Loss_G: 2.4320
[Continued 175/200] Loss_D: 0.6397 Loss_G: 3.6916
[Continued 176/200] Loss_D: 0.6213 Loss_G: 3.0175
[Continued 177/200] Loss_D: 0.5330 Loss_G: 2.5551
[Continued 178/200] Loss_D: 0.4925 Loss_G: 3.2395
[Continued 179/200] Loss_D: 0.4954 Loss_G: 3.4882
[Continued 180/200] Loss_D: 0.6521 Loss_G: 4.3227
[Continued 181/200] Loss_D: 0.5248 Loss_G: 2.1134
[Continued 182/200] Loss_D: 0.5594 Loss_G: 3.6489
[Continued 183/200] Loss_D: 0.9886 Loss_G: 5.2549
[Continued 184/200] Loss_D: 0.6485 Loss_G: 2.2813
[Continued 185/200] Loss_D: 0.5600 Loss_G: 3.3691
[Continued 186/200] Loss_D: 0.5909 Loss_G: 3.0950
[Continued 187/200] Loss_D: 0.6218 Loss_G: 3.1941
[Continued 188/200] Loss_D: 0.5279 Loss_G: 3.5040
[Continued 189/200] Loss_D: 0.6470 Loss_G: 4.4466
[Continued 190/200] Loss_D: 0.4574 Loss_G: 2.7459
[Continued 191/200] Loss_D: 0.5014 Loss_G: 3.0155
[Continued 192/200] Loss_D: 0.5398 Loss_G: 3.3240
[Continued 193/200] Loss_D: 0.6250 Loss_G: 4.4178
[Continued 194/200] Loss_D: 0.5702 Loss_G: 3.0712
[Continued 195/200] Loss_D: 0.5767 Loss_G: 3.5147
[Continued 196/200] Loss_D: 0.6645 Loss_G: 1.8137
[Continued 197/200] Loss_D: 0.5158 Loss_G: 3.7876
[Continued 198/200] Loss_D: 0.5209 Loss_G: 3.5777
[Continued 199/200] Loss_D: 0.6209 Loss_G: 3.5703
[Continued 200/200] Loss_D: 0.5083 Loss_G: 3.4347
Evaluating Generator Output (Round 2)
By 300 epochs, the generator has completed 300 full passes over the dataset, and each pass has updated its weights based on gradient signals from the discriminator. The images at this stage should show more committed structural features than at round one: cleaner edges, more consistent radial symmetry, and some attempt at the texture variation visible in real sea star arms.
This is also the stage where the first failure modes become clearly distinguishable from progress. If you see a grid with 16 nearly identical outputs, the generator has collapsed onto a single mode of the data distribution. The discriminator classifies that one output as plausibly real, so the generator has no incentive to explore further. This is mode collapse, and it is the most common failure in DCGAN training.
If the images remain blurry but show diverse structural variations across the 16 samples, training is progressing normally. Diversity of form across the grid is the primary indicator of a healthy generator at this stage, ahead of sharpness.
import torchvision.utils as vutils

# Generate a batch of fake images
noise = torch.randn(16, nz, 1, 1, device=device)
with torch.no_grad():
    fake_images = netG(noise).detach().cpu()

# Plot the fake images
plt.figure(figsize=(8,8))
plt.axis("off")
plt.title("Synthetic Sea Stars")
plt.imshow(np.transpose(vutils.make_grid(fake_images, padding=2, normalize=True), (1, 2, 0)))
plt.show()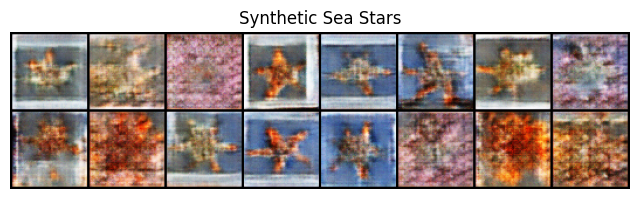
Third Training Block: Epochs 301 to 500
At this point in training, the generator has established basic structural patterns and the discriminator has adapted to them. The next 200 epochs tend to produce the steepest visible improvements in image quality, because both networks are operating in a regime where neither has completely outpaced the other.
Pay particular attention to the loss values printed at the end of each epoch. The discriminator loss on real images (D(x)) and on fake images (D(G(z))) are printed alongside the total generator and discriminator losses. Ideally, D(x) should remain close to 1 (real images classified as real) and D(G(z)) should be gradually moving from near 0 (fakes correctly identified) toward something closer to 0.5 (fakes becoming difficult to distinguish). That convergence in the fake classification confidence is the quantitative sign that the generator is improving.
additional_epochs = 200

print(f"Resuming Training Loop for {additional_epochs} more epochs...")
for epoch in range(additional_epochs):
    for i, data in enumerate(dataloader, 0):
        # 1. Update Discriminator
        netD.zero_grad()
        real_cpu = data.to(device)
        b_size = real_cpu.size(0)

        # Real labels are smoothed to 0.9
        label = torch.full((b_size,), 0.9, dtype=torch.float, device=device)
        output = netD(real_cpu).view(-1)
        errD_real = criterion(output, label)
        errD_real.backward()

        noise = torch.randn(b_size, nz, 1, 1, device=device)
        fake = netG(noise)
        label.fill_(0.)
        output = netD(fake.detach()).view(-1)
        errD_fake = criterion(output, label)
        errD_fake.backward()
        optimizerD.step()

        # 2. Update Generator
        netG.zero_grad()
        label.fill_(1.)  # fake labels are real for generator cost
        output = netD(fake).view(-1)
        errG = criterion(output, label)
        errG.backward()
        optimizerG.step()

    print(f'[Continued {epoch+1}/{additional_epochs}] Loss_D: {errD_real.item() + errD_fake.item():.4f} Loss_G: {errG.item():.4f}')
Resuming Training Loop for 200 more epochs...
[Continued 1/200] Loss_D: 0.5125 Loss_G: 2.6331
[Continued 2/200] Loss_D: 0.7372 Loss_G: 4.9431
[Continued 3/200] Loss_D: 0.5192 Loss_G: 2.5715
[Continued 4/200] Loss_D: 0.6224 Loss_G: 2.5084
[Continued 5/200] Loss_D: 0.5406 Loss_G: 2.9801
[Continued 6/200] Loss_D: 0.5834 Loss_G: 3.8782
[Continued 7/200] Loss_D: 0.5122 Loss_G: 3.1230
[Continued 8/200] Loss_D: 0.5397 Loss_G: 2.4609
[Continued 9/200] Loss_D: 0.4761 Loss_G: 3.2155
[Continued 10/200] Loss_D: 0.4869 Loss_G: 2.8480
[Continued 11/200] Loss_D: 0.4990 Loss_G: 3.0622
[Continued 12/200] Loss_D: 0.4963 Loss_G: 2.8355
[Continued 13/200] Loss_D: 0.5681 Loss_G: 2.0161
[Continued 14/200] Loss_D: 0.6147 Loss_G: 3.4867
[Continued 15/200] Loss_D: 0.5416 Loss_G: 3.3553
[Continued 16/200] Loss_D: 0.8893 Loss_G: 5.6782
[Continued 17/200] Loss_D: 0.4675 Loss_G: 3.1192
[Continued 18/200] Loss_D: 0.4804 Loss_G: 3.0038
[Continued 19/200] Loss_D: 0.4884 Loss_G: 2.6657
[Continued 20/200] Loss_D: 0.5449 Loss_G: 3.9311
[Continued 21/200] Loss_D: 0.5482 Loss_G: 3.2731
[Continued 22/200] Loss_D: 0.6164 Loss_G: 2.4836
[Continued 23/200] Loss_D: 0.5589 Loss_G: 3.0589
[Continued 24/200] Loss_D: 0.5813 Loss_G: 2.2192
[Continued 25/200] Loss_D: 0.5674 Loss_G: 3.2581
[Continued 26/200] Loss_D: 0.5378 Loss_G: 3.2350
[Continued 27/200] Loss_D: 0.5669 Loss_G: 2.3829
[Continued 28/200] Loss_D: 0.7098 Loss_G: 2.0375
[Continued 29/200] Loss_D: 0.4534 Loss_G: 3.6566
[Continued 30/200] Loss_D: 0.5968 Loss_G: 2.4104
[Continued 31/200] Loss_D: 0.4870 Loss_G: 3.9326
[Continued 32/200] Loss_D: 0.5988 Loss_G: 3.9974
[Continued 33/200] Loss_D: 0.4921 Loss_G: 3.8446
[Continued 34/200] Loss_D: 0.5167 Loss_G: 3.1294
[Continued 35/200] Loss_D: 0.5451 Loss_G: 2.0191
[Continued 36/200] Loss_D: 0.4565 Loss_G: 3.5016
[Continued 37/200] Loss_D: 0.4675 Loss_G: 2.6763
[Continued 38/200] Loss_D: 0.7783 Loss_G: 1.6061
[Continued 39/200] Loss_D: 0.4959 Loss_G: 3.5899
[Continued 40/200] Loss_D: 0.5445 Loss_G: 2.1485
[Continued 41/200] Loss_D: 0.4996 Loss_G: 2.8211
[Continued 42/200] Loss_D: 0.4700 Loss_G: 3.4215
[Continued 43/200] Loss_D: 0.8054 Loss_G: 5.0603
[Continued 44/200] Loss_D: 0.7243 Loss_G: 1.3265
[Continued 45/200] Loss_D: 0.6405 Loss_G: 4.4960
[Continued 46/200] Loss_D: 0.6695 Loss_G: 2.2918
[Continued 47/200] Loss_D: 0.5813 Loss_G: 3.9282
[Continued 48/200] Loss_D: 0.5663 Loss_G: 3.3078
[Continued 49/200] Loss_D: 0.6185 Loss_G: 3.2224
[Continued 50/200] Loss_D: 0.5300 Loss_G: 3.2006
[Continued 51/200] Loss_D: 0.5162 Loss_G: 3.2611
[Continued 52/200] Loss_D: 0.4957 Loss_G: 3.4025
[Continued 53/200] Loss_D: 0.5133 Loss_G: 2.5335
[Continued 54/200] Loss_D: 0.4770 Loss_G: 3.3045
[Continued 55/200] Loss_D: 0.4735 Loss_G: 3.4018
[Continued 56/200] Loss_D: 0.5447 Loss_G: 3.4072
[Continued 57/200] Loss_D: 0.4845 Loss_G: 3.0212
[Continued 58/200] Loss_D: 0.4647 Loss_G: 2.8451
[Continued 59/200] Loss_D: 0.4723 Loss_G: 3.1673
[Continued 60/200] Loss_D: 0.4516 Loss_G: 3.3192
[Continued 61/200] Loss_D: 0.4572 Loss_G: 3.3844
[Continued 62/200] Loss_D: 0.4534 Loss_G: 3.1133
[Continued 63/200] Loss_D: 0.4676 Loss_G: 3.0965
[Continued 64/200] Loss_D: 0.6674 Loss_G: 5.3434
[Continued 65/200] Loss_D: 0.4583 Loss_G: 2.7844
[Continued 66/200] Loss_D: 0.5358 Loss_G: 3.2420
[Continued 67/200] Loss_D: 0.5252 Loss_G: 3.5644
[Continued 68/200] Loss_D: 0.5013 Loss_G: 3.0667
[Continued 69/200] Loss_D: 0.4353 Loss_G: 3.6513
[Continued 70/200] Loss_D: 0.4576 Loss_G: 3.8379
[Continued 71/200] Loss_D: 0.5063 Loss_G: 3.2063
[Continued 72/200] Loss_D: 0.4940 Loss_G: 3.1058
[Continued 73/200] Loss_D: 0.6143 Loss_G: 4.7382
[Continued 74/200] Loss_D: 0.4458 Loss_G: 3.4698
[Continued 75/200] Loss_D: 0.4944 Loss_G: 4.3377
[Continued 76/200] Loss_D: 0.4977 Loss_G: 3.4571
[Continued 77/200] Loss_D: 0.6009 Loss_G: 1.9070
[Continued 78/200] Loss_D: 0.4764 Loss_G: 4.0963
[Continued 79/200] Loss_D: 0.4953 Loss_G: 3.6828
[Continued 80/200] Loss_D: 0.4429 Loss_G: 3.1598
[Continued 81/200] Loss_D: 0.4826 Loss_G: 3.4882
[Continued 82/200] Loss_D: 0.5119 Loss_G: 2.6914
[Continued 83/200] Loss_D: 0.4727 Loss_G: 3.0134
[Continued 84/200] Loss_D: 0.4787 Loss_G: 3.4945
[Continued 85/200] Loss_D: 0.4067 Loss_G: 3.8146
[Continued 86/200] Loss_D: 0.4449 Loss_G: 3.3415
[Continued 87/200] Loss_D: 0.4288 Loss_G: 3.8547
[Continued 88/200] Loss_D: 0.4897 Loss_G: 4.0451
[Continued 89/200] Loss_D: 0.5136 Loss_G: 3.9370
[Continued 90/200] Loss_D: 0.4542 Loss_G: 3.2199
[Continued 91/200] Loss_D: 0.6016 Loss_G: 1.9883
[Continued 92/200] Loss_D: 0.4230 Loss_G: 4.3080
[Continued 93/200] Loss_D: 0.9098 Loss_G: 6.3895
[Continued 94/200] Loss_D: 0.4913 Loss_G: 3.0814
[Continued 95/200] Loss_D: 0.5853 Loss_G: 2.4839
[Continued 96/200] Loss_D: 0.4857 Loss_G: 3.7233
[Continued 97/200] Loss_D: 0.4709 Loss_G: 2.5655
[Continued 98/200] Loss_D: 0.5189 Loss_G: 3.8249
[Continued 99/200] Loss_D: 0.4457 Loss_G: 3.2621
[Continued 100/200] Loss_D: 0.4399 Loss_G: 3.1131
[Continued 101/200] Loss_D: 0.4866 Loss_G: 2.4544
[Continued 102/200] Loss_D: 0.4357 Loss_G: 3.2367
[Continued 103/200] Loss_D: 0.3963 Loss_G: 3.5632
[Continued 104/200] Loss_D: 0.4850 Loss_G: 3.3763
[Continued 105/200] Loss_D: 0.5475 Loss_G: 4.0510
[Continued 106/200] Loss_D: 0.5282 Loss_G: 2.2991
[Continued 107/200] Loss_D: 0.4246 Loss_G: 3.8819
[Continued 108/200] Loss_D: 0.7774 Loss_G: 4.7346
[Continued 109/200] Loss_D: 0.4862 Loss_G: 2.6007
[Continued 110/200] Loss_D: 0.4440 Loss_G: 3.0425
[Continued 111/200] Loss_D: 0.4466 Loss_G: 2.8317
[Continued 112/200] Loss_D: 0.4298 Loss_G: 3.9381
[Continued 113/200] Loss_D: 0.4811 Loss_G: 2.2395
[Continued 114/200] Loss_D: 0.4132 Loss_G: 3.5915
[Continued 115/200] Loss_D: 0.4292 Loss_G: 2.7693
[Continued 116/200] Loss_D: 0.5739 Loss_G: 1.9632
[Continued 117/200] Loss_D: 0.4695 Loss_G: 3.4783
[Continued 118/200] Loss_D: 0.5190 Loss_G: 2.3787
[Continued 119/200] Loss_D: 0.5735 Loss_G: 2.3269
[Continued 120/200] Loss_D: 0.4830 Loss_G: 3.1813
[Continued 121/200] Loss_D: 0.4184 Loss_G: 3.7823
[Continued 122/200] Loss_D: 0.5390 Loss_G: 1.7634
[Continued 123/200] Loss_D: 0.6524 Loss_G: 2.9362
[Continued 124/200] Loss_D: 0.5184 Loss_G: 4.3630
[Continued 125/200] Loss_D: 0.6667 Loss_G: 4.8802
[Continued 126/200] Loss_D: 0.4628 Loss_G: 2.7178
[Continued 127/200] Loss_D: 0.4174 Loss_G: 3.4756
[Continued 128/200] Loss_D: 0.4822 Loss_G: 2.8151
[Continued 129/200] Loss_D: 0.4417 Loss_G: 3.0619
[Continued 130/200] Loss_D: 0.4415 Loss_G: 3.2535
[Continued 131/200] Loss_D: 0.5357 Loss_G: 4.5821
[Continued 132/200] Loss_D: 0.4741 Loss_G: 2.9632
[Continued 133/200] Loss_D: 0.4535 Loss_G: 3.2432
[Continued 134/200] Loss_D: 0.4282 Loss_G: 3.4806
[Continued 135/200] Loss_D: 0.5860 Loss_G: 1.6671
[Continued 136/200] Loss_D: 0.7126 Loss_G: 1.3824
[Continued 137/200] Loss_D: 0.5621 Loss_G: 3.6917
[Continued 138/200] Loss_D: 0.5586 Loss_G: 3.0086
[Continued 139/200] Loss_D: 0.4321 Loss_G: 3.0990
[Continued 140/200] Loss_D: 0.4330 Loss_G: 3.6289
[Continued 141/200] Loss_D: 0.5255 Loss_G: 3.6764
[Continued 142/200] Loss_D: 0.4214 Loss_G: 3.0483
[Continued 143/200] Loss_D: 0.4434 Loss_G: 2.9134
[Continued 144/200] Loss_D: 0.4400 Loss_G: 3.1226
[Continued 145/200] Loss_D: 0.4743 Loss_G: 2.8308
[Continued 146/200] Loss_D: 0.4276 Loss_G: 3.8759
[Continued 147/200] Loss_D: 0.4227 Loss_G: 3.9301
[Continued 148/200] Loss_D: 0.4854 Loss_G: 2.2518
[Continued 149/200] Loss_D: 0.4429 Loss_G: 4.0228
[Continued 150/200] Loss_D: 0.5349 Loss_G: 2.0637
[Continued 151/200] Loss_D: 0.4304 Loss_G: 3.3775
[Continued 152/200] Loss_D: 0.4657 Loss_G: 3.6952
[Continued 153/200] Loss_D: 0.6884 Loss_G: 5.3874
[Continued 154/200] Loss_D: 0.4477 Loss_G: 3.0598
[Continued 155/200] Loss_D: 0.4071 Loss_G: 3.5827
[Continued 156/200] Loss_D: 0.4266 Loss_G: 3.8804
[Continued 157/200] Loss_D: 0.4169 Loss_G: 3.4097
[Continued 158/200] Loss_D: 0.4569 Loss_G: 2.4953
[Continued 159/200] Loss_D: 0.4064 Loss_G: 4.1760
[Continued 160/200] Loss_D: 0.4702 Loss_G: 2.7032
[Continued 161/200] Loss_D: 0.4246 Loss_G: 3.4318
[Continued 162/200] Loss_D: 0.4553 Loss_G: 2.6243
[Continued 163/200] Loss_D: 0.4276 Loss_G: 3.5355
[Continued 164/200] Loss_D: 0.5106 Loss_G: 2.3435
[Continued 165/200] Loss_D: 0.4373 Loss_G: 2.9248
[Continued 166/200] Loss_D: 0.4285 Loss_G: 3.3839
[Continued 167/200] Loss_D: 0.4194 Loss_G: 3.2696
[Continued 168/200] Loss_D: 0.4529 Loss_G: 3.9822
[Continued 169/200] Loss_D: 0.4168 Loss_G: 2.9679
[Continued 170/200] Loss_D: 0.4129 Loss_G: 3.4200
[Continued 171/200] Loss_D: 0.4503 Loss_G: 2.5836
[Continued 172/200] Loss_D: 2.1917 Loss_G: 2.2005
[Continued 173/200] Loss_D: 1.0954 Loss_G: 4.3097
[Continued 174/200] Loss_D: 0.5499 Loss_G: 3.8874
[Continued 175/200] Loss_D: 0.5346 Loss_G: 3.3852
[Continued 176/200] Loss_D: 0.4873 Loss_G: 2.9710
[Continued 177/200] Loss_D: 0.4485 Loss_G: 3.4384
[Continued 178/200] Loss_D: 0.4552 Loss_G: 3.8265
[Continued 179/200] Loss_D: 0.4622 Loss_G: 2.7541
[Continued 180/200] Loss_D: 0.4675 Loss_G: 3.4523
[Continued 181/200] Loss_D: 0.4353 Loss_G: 3.3454
[Continued 182/200] Loss_D: 0.4191 Loss_G: 3.2946
[Continued 183/200] Loss_D: 0.4933 Loss_G: 3.4855
[Continued 184/200] Loss_D: 0.4533 Loss_G: 2.6501
[Continued 185/200] Loss_D: 0.4200 Loss_G: 3.7275
[Continued 186/200] Loss_D: 0.4318 Loss_G: 2.6377
[Continued 187/200] Loss_D: 0.4470 Loss_G: 3.6958
[Continued 188/200] Loss_D: 0.4267 Loss_G: 2.9322
[Continued 189/200] Loss_D: 0.4257 Loss_G: 3.3291
[Continued 190/200] Loss_D: 0.4120 Loss_G: 3.3029
[Continued 191/200] Loss_D: 0.4081 Loss_G: 3.0395
[Continued 192/200] Loss_D: 0.4042 Loss_G: 3.0298
[Continued 193/200] Loss_D: 0.4313 Loss_G: 3.5031
[Continued 194/200] Loss_D: 0.4017 Loss_G: 3.0121
[Continued 195/200] Loss_D: 0.4166 Loss_G: 3.2466
[Continued 196/200] Loss_D: 0.3958 Loss_G: 3.2150
[Continued 197/200] Loss_D: 0.4127 Loss_G: 2.8517
[Continued 198/200] Loss_D: 0.3922 Loss_G: 3.5521
[Continued 199/200] Loss_D: 0.4333 Loss_G: 2.8708
[Continued 200/200] Loss_D: 0.3906 Loss_G: 3.7101
Evaluating Generator Output (Round 3)
At 500 epochs, the generator has had substantial opportunity to develop the multi-scale features that distinguish recognizable synthetic sea stars from structured noise. At this resolution (64x64 pixels), the realistic upper bound on quality is already fairly close: the network does not have enough parameters or spatial resolution to reconstruct photographic detail, but it should be producing shapes with five-fold symmetry, coherent arm textures, and distinct foreground-background separation.
Look for the following specific quality indicators in the 16-image grid:
Arm definition: Are the arms distinct from the body, or does the whole shape blur together?
Color distribution: Is the color palette consistent across samples, or does it vary in ways that reflect actual sea star coloration?
Background handling: Is the background relatively uniform, or does it contain artifact patterns that reveal the generator is struggling?
Diversity across the 16 samples remains as important as individual image quality. A generator that produces one or two convincing images and fourteen near-duplicates is still exhibiting partial mode collapse.
import torchvision.utils as vutils

# Generate a batch of fake images
noise = torch.randn(16, nz, 1, 1, device=device)
with torch.no_grad():
    fake_images = netG(noise).detach().cpu()

# Plot the fake images
plt.figure(figsize=(8,8))
plt.axis("off")
plt.title("Synthetic Sea Stars")
plt.imshow(np.transpose(vutils.make_grid(fake_images, padding=2, normalize=True), (1, 2, 0)))
plt.show()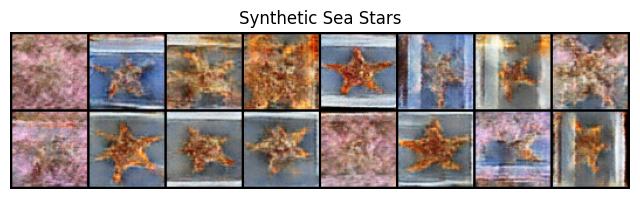
Final Training Block: Epochs 501 to 700
This is the last training block before the final evaluation. At 700 total epochs, a DCGAN on a small, relatively uniform dataset like this one has generally reached whatever quality ceiling the architecture and dataset size will allow. Further training past this point tends to yield diminishing returns or, in some cases, degradation if the discriminator has become too well-calibrated and is suppressing the generator’s gradient.
The final state of both networks depends heavily on initial random seed values, dataset size, and the stability of the loss dynamics you observed in earlier rounds. Two students running this notebook from scratch with the same code but different GPU hardware may see noticeably different output quality at this stage, because small differences in floating-point timing and batch ordering affect the entire training trajectory.
additional_epochs = 200

print(f"Resuming Training Loop for {additional_epochs} more epochs...")
for epoch in range(additional_epochs):
    for i, data in enumerate(dataloader, 0):
        # 1. Update Discriminator
        netD.zero_grad()
        real_cpu = data.to(device)
        b_size = real_cpu.size(0)

        # Real labels are smoothed to 0.9
        label = torch.full((b_size,), 0.9, dtype=torch.float, device=device)
        output = netD(real_cpu).view(-1)
        errD_real = criterion(output, label)
        errD_real.backward()

        noise = torch.randn(b_size, nz, 1, 1, device=device)
        fake = netG(noise)
        label.fill_(0.)
        output = netD(fake.detach()).view(-1)
        errD_fake = criterion(output, label)
        errD_fake.backward()
        optimizerD.step()

        # 2. Update Generator
        netG.zero_grad()
        label.fill_(1.)  # fake labels are real for generator cost
        output = netD(fake).view(-1)
        errG = criterion(output, label)
        errG.backward()
        optimizerG.step()

    print(f'[Continued {epoch+1}/{additional_epochs}] Loss_D: {errD_real.item() + errD_fake.item():.4f} Loss_G: {errG.item():.4f}')
Final Output at Full Scale
This cell generates 32 images arranged in a 4-by-8 grid, giving you a larger sample to assess two properties that are invisible in a 16-image grid: diversity and systematic artifact patterns.
Diversity is the primary concern for data augmentation use cases. If you intend to use these synthetic images to expand a training set, you need the generated distribution to cover the real distribution’s full range, not just a single representative example. Scan the grid for mode collapse: if all 32 images look nearly identical (same arm configuration, same coloring, same background), the generator has found a single output that fools the discriminator and stopped exploring.
Artifact patterns reveal architectural limitations. Checkerboard artifacts, which appear as a regular grid of light and dark squares superimposed on the image content, are a known side effect of transpose convolutions when the kernel size is not divisible by the stride. If you see them, they indicate aliasing in the upsampling layers rather than a training failure.
Compare this grid with the first 16-image grid from 100 epochs. The improvement in sharpness and structural coherence across that span is the clearest visual record of what 700 epochs of adversarial training actually accomplishes.
import torchvision.utils as vutils

# Generate a batch of fake images
noise = torch.randn(32, nz, 1, 1, device=device)
with torch.no_grad():
    fake_images = netG(noise).detach().cpu()

# Plot the fake images
plt.figure(figsize=(16,16))
plt.axis("off")
plt.title("Synthetic Sea Stars")
plt.imshow(np.transpose(vutils.make_grid(fake_images, padding=2, normalize=True), (1, 2, 0)))
plt.show()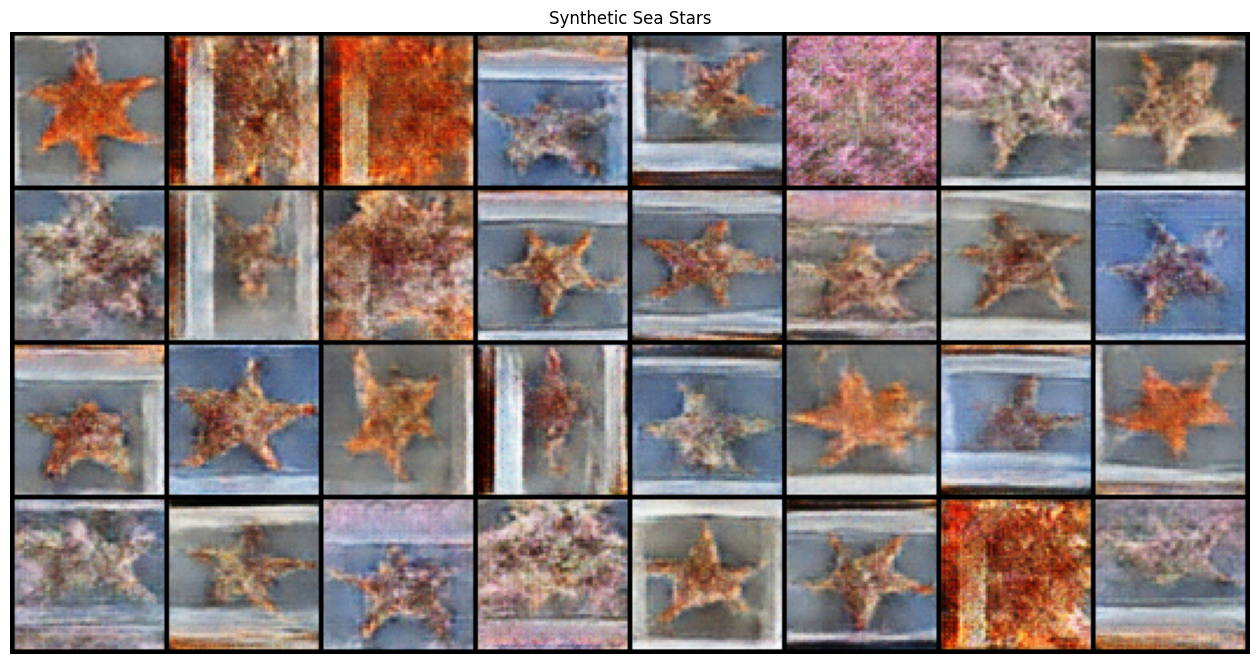
Saving Model Weights
The two torch.save() calls write the generator and discriminator state dictionaries to .pth files, then the Colab files.download() utility triggers a browser download so the weights are preserved beyond the session.
Saving netG_weights.pth is the most practically important step. The generator’s learned weights encode everything the network discovered about the distribution of sea star imagery: shape, texture, color range, and the spatial relationships between arm structures. You can reload these weights at any later point using netG.load_state_dict(torch.load('netG_weights.pth')) and immediately generate additional synthetic samples without repeating the full training run.
The discriminator weights (netD_weights.pth) are also saved for two reasons. First, if you want to resume training on new data, you need both networks in their current state so the adversarial balance is preserved from where it left off. Second, trained discriminators can serve as feature extractors in their own right: the internal representations a discriminator learns in order to distinguish real from fake images often encode useful perceptual features that transfer to classification and anomaly detection tasks.
from google.colab import files
import torch

# Save the weights to local files
torch.save(netG.state_dict(), 'netG_weights.pth')
torch.save(netD.state_dict(), 'netD_weights.pth')

# Trigger the download
files.download('netG_weights.pth')
files.download('netD_weights.pth')

print("Downloading weights...")Downloading weights...
Reflecting on Results
Review the generated image grids from each training stage before answering these questions.
At roughly what epoch count did the generated images first become recognizable as sea stars rather than noise or abstract blobs? What changes in the generator loss and discriminator loss coincided with that transition? Look for the point where the discriminator loss stops collapsing toward zero and the two losses begin to track each other more closely.
Frechet Inception Distance (FID) is the standard quantitative metric for GAN output quality. FID computes feature-space statistics (mean and covariance) of real and generated images using an Inception-v3 network, then measures the distance between the two distributions. A lower FID indicates that generated images are closer to real ones in perceptual feature space. How would you set up an FID evaluation here, and what FID score would you consider acceptable for a training data augmentation use case?
Which other rare or difficult-to-photograph marine species would benefit most from GAN-based augmentation? Consider animals whose rarity, depth range, or behavioral unpredictability makes large annotated datasets practically impossible to collect, and explain what properties of those species might make GAN training more or less tractable.